1. SQL 학습을 위한 데이터베이스 구조

1.1 마당서점 시스템

마당서점 시스템은 도서, 고객, 주문 정보를 데이터베이스에 저장하여 관리한다. 운영자와 고객은 응용 프로그램을 통해 데이터를 조회하거나 처리하고, DBMS는 저장된 데이터와 접근 권한을 관리한다.

실습에서 사용하는 주요 테이블은 다음과 같다. 강의자료의 제목에는 Order라는 표현도 나오지만, 예제 SQL과 데이터 구조에 맞춰 실제 쿼리에서는 Orders를 사용한다.

테이블역할주요 컬럼
Book 도서 정보 저장 bookid, bookname, publisher, price
Customer 고객 정보 저장 custid, name, address, phone
Orders 주문 정보 저장 orderid, custid, bookid, saleprice, orderdate
  • Book.bookid: 도서번호
  • Book.bookname: 도서이름
  • Book.publisher: 출판사
  • Book.price: 도서의 가격
  • Customer.custid: 고객번호
  • Orders.orderid: 주문번호
  • Orders.custid: 주문한 고객의 번호
  • Orders.bookid: 주문한 도서의 번호
  • Orders.saleprice: 실제 판매가격
  • Orders.orderdate: 주문일자

Book.price와 Orders.saleprice는 구분해야 한다. 전자는 도서 정보에 등록된 가격이고, 후자는 주문에 기록된 실제 판매가격이다. 총판매액은 Orders.saleprice를 이용하여 계산한다.

1.2 실습 환경과 기본 명령어

강의자료는 MySQL 8.0 이상을 기준으로 하며, HeidiSQL 또는 MySQL Workbench를 이용한다. SQL 클라이언트에서 샘플 스크립트 demo_madang.sql을 실행하여 실습 데이터베이스와 데이터를 준비한다. 접속 계정과 비밀번호는 실제 설치 환경의 설정을 사용한다.

-- 서버에 존재하는 데이터베이스 목록 확인
SHOW DATABASES;

-- 실습 데이터베이스 선택
USE madangdb;

-- 선택한 데이터베이스의 테이블 목록 확인
SHOW TABLES;

-- 각 테이블의 컬럼 구조 확인
DESC Book;
DESC Customer;
DESC Orders;

USE는 이후 SQL을 실행할 기본 데이터베이스를 선택하는 명령이다. DESC는 컬럼 이름, 자료형, NULL 허용 여부, 키 정보 등을 확인할 때 사용한다.

2. SQL의 개념과 분류

2.1 SQL이란?

SQL은 Structured Query Language의 약자로, 관계 데이터베이스에서 데이터를 정의하고 조회·조작하며 접근 권한을 관리하는 언어이다. SYSTEM R의 질의 언어인 SEQUEL에서 유래하였으며, ANSI와 ISO의 표준화 과정을 거쳤다.

SQL은 비절차적 언어이다. 사용자가 원하는 데이터와 조건을 명시하면, DBMS가 데이터를 찾고 처리하는 실행 방법을 결정한다.

예를 들어 다음 SQL은 가격이 10,000원 이상인 도서의 이름과 출판사를 요청한다.

SELECT bookname, publisher
FROM Book
WHERE price >= 10000;

이 문장에는 데이터를 어떤 순서로 읽을지, 인덱스를 사용할지 등의 물리적인 처리 방법이 직접 지정되어 있지 않다.

2.2 SQL의 사용 방식

사용 방식설명
대화식 SQL SQL 클라이언트에서 질의를 직접 작성하고 실행하는 방식
삽입 SQL 응용 프로그램에 SQL을 포함하여 데이터를 처리하는 방식

2.3 SQL의 분류

분류의미주요 명령어
DDL 데이터베이스 객체의 구조를 정의하거나 변경·삭제 CREATE, ALTER, DROP
DML 저장된 데이터를 검색하거나 삽입·수정·삭제 SELECT, INSERT, UPDATE, DELETE
DCL 사용자에게 데이터 접근 및 사용 권한을 부여하거나 회수 GRANT, REVOKE

이 글에서는 강의자료의 분류에 따라 SELECT를 DML에 포함한다.

3. SELECT 문의 기본 구조

SELECT는 테이블에서 데이터를 검색하는 명령이다. 검색 결과는 행과 열로 구성된 형태로 반환된다.

SELECT 컬럼명
FROM 테이블명
WHERE 검색조건;
절역할
SELECT 결과에 표시할 컬럼이나 계산식 지정
FROM 검색할 테이블 지정
WHERE 검색할 행의 조건 지정

WHERE는 생략할 수 있으며, 생략하면 테이블의 모든 행을 검색 대상으로 한다.

3.1 원하는 컬럼 조회

실습: 모든 도서의 이름과 가격을 검색한다.

SELECT bookname, price
FROM Book;

결과에는 bookname, price 두 컬럼만 표시된다. SELECT에 작성한 컬럼의 순서가 결과의 열 순서를 결정한다.

SELECT price, bookname
FROM Book;

위 쿼리는 같은 데이터를 조회하지만 가격이 먼저, 도서이름이 나중에 표시된다.

3.2 모든 컬럼 조회

실습: 모든 도서의 도서번호, 도서이름, 출판사, 가격을 검색한다.

SELECT bookid, bookname, publisher, price
FROM Book;

테이블의 모든 컬럼을 조회할 때는 *를 사용할 수 있다.

SELECT *
FROM Book;

*는 모든 행이라는 뜻이 아니라 모든 컬럼을 선택한다는 뜻이다. 행의 선택은 WHERE 조건이 결정한다.

3.3 중복 허용과 제거: ALL, DISTINCT

일반적인 SELECT는 검색 결과의 중복을 허용한다. ALL을 명시해도 같은 의미이며, 생략할 수 있다.

SELECT publisher
FROM Book;

SELECT ALL publisher
FROM Book;

실습: 도서 테이블에 있는 출판사를 중복 없이 검색한다.

SELECT DISTINCT publisher
FROM Book;

같은 출판사의 도서가 여러 권 있더라도 결과에는 해당 출판사가 한 번만 표시된다.

DISTINCT는 선택한 컬럼 전체의 조합을 기준으로 중복을 제거한다.

SELECT DISTINCT publisher, price
FROM Book;

위 쿼리에서는 출판사가 같더라도 가격이 다르면 서로 다른 결과 행으로 남는다.

4. WHERE를 이용한 조건 검색

4.1 비교 연산자

연산자의미
= 같다
<> 또는 != 같지 않다
> 크다
>= 크거나 같다
< 작다
<= 작거나 같다

실습: 가격이 20,000원 미만인 도서를 검색한다.

SELECT *
FROM Book
WHERE price < 20000;

20,000원인 도서는 포함하지 않는다. 20,000원도 포함하려면 <=를 사용한다.

문자열 값은 작은따옴표로 감싸서 작성한다.

SELECT *
FROM Book
WHERE publisher = '굿스포츠';

4.2 범위 검색: BETWEEN

BETWEEN A AND B는 A 이상 B 이하의 범위를 검색하며, 양쪽 경계값을 모두 포함한다.

실습: 가격이 10,000원 이상 20,000원 이하인 도서를 검색한다.

SELECT *
FROM Book
WHERE price BETWEEN 10000 AND 20000;

비교 연산자와 AND를 사용해도 같은 조건을 나타낼 수 있다.

SELECT *
FROM Book
WHERE price >= 10000
  AND price <= 20000;

4.3 집합 검색: IN, NOT IN

IN은 값이 지정한 목록에 포함되는지 검사한다.

실습: 출판사가 굿스포츠 또는 대한미디어인 도서를 검색한다.

SELECT *
FROM Book
WHERE publisher IN ('굿스포츠', '대한미디어');

NOT IN은 목록에 포함되지 않는 값을 검색한다.

실습: 출판사가 굿스포츠도 대한미디어도 아닌 도서를 검색한다.

SELECT *
FROM Book
WHERE publisher NOT IN ('굿스포츠', '대한미디어');

NULL은 일반적인 비교로 참·거짓을 확정할 수 없는 값이다. publisher가 NULL인 행은 위의 NOT IN 조건으로 선택되지 않는다. NULL 여부를 검사할 때는 IS NULL 또는 IS NOT NULL을 사용한다.

4.4 문자열 패턴 검색: LIKE

LIKE는 문자열이 특정 패턴에 맞는지 검사한다.

와일드카드의미예시
% 0개 이상의 문자 '%축구%'
_ 정확히 한 개의 문자 '_구%'

실습: 도서이름이 축구의 역사인 도서의 출판사를 검색한다.

SELECT publisher
FROM Book
WHERE bookname = '축구의 역사';

전체 문자열이 일치하는 조건이므로 =를 사용한다.

실습: 도서이름에 축구가 포함된 도서의 출판사를 검색한다.

SELECT publisher
FROM Book
WHERE bookname LIKE '%축구%';

%축구%는 앞뒤에 다른 문자가 있거나 없어도 문자열 안에 '축구'가 포함되면 일치한다.

-- 도서이름이 '축구'로 시작
SELECT *
FROM Book
WHERE bookname LIKE '축구%';

-- 도서이름이 '축구'로 끝남
SELECT *
FROM Book
WHERE bookname LIKE '%축구';

실습: 도서이름의 두 번째 문자가 구인 도서를 검색한다.

SELECT *
FROM Book
WHERE bookname LIKE '_구%';

첫 번째 _가 한 문자를 차지하고, 두 번째 위치의 '구'가 일치해야 한다. 이후에는 %에 의해 어떤 문자열이든 올 수 있다.

실습: 출판사가 대로 시작하고 이름이 정확히 다섯 글자인 도서를 검색한다.

SELECT *
FROM Book
WHERE publisher LIKE '대____';

'대' 한 글자와 _ 네 개를 합쳐 정확히 다섯 글자를 검사한다. 패턴 검색에는 LIKE를 사용해야 한다. publisher = '대____'는 밑줄을 와일드카드로 해석하지 않고 해당 문자열 자체와 비교한다.

4.5 복합 조건: AND, OR, NOT

연산자의미
AND 두 조건을 모두 만족
OR 두 조건 중 하나 이상 만족
NOT 조건의 논리값을 부정

실습: 축구에 관한 도서 중 가격이 20,000원 이상인 도서를 검색한다.

SELECT *
FROM Book
WHERE bookname LIKE '%축구%'
  AND price >= 20000;

도서이름에 '축구'가 포함되면서 가격 조건도 만족해야 한다.

실습: 출판사가 굿스포츠 또는 대한미디어인 도서를 OR로 검색한다.

SELECT *
FROM Book
WHERE publisher = '굿스포츠'
   OR publisher = '대한미디어';

AND와 OR를 함께 사용하면 AND가 먼저 적용된다. 조건을 묶으려면 괄호를 사용한다.

SELECT *
FROM Book
WHERE (publisher = '굿스포츠' OR publisher = '대한미디어')
  AND price >= 10000;

위 조건은 두 출판사 중 하나에 속하는 도서 가운데 가격이 10,000원 이상인 도서를 검색한다.

5. ORDER BY를 이용한 정렬

ORDER BY는 조회 결과의 출력 순서를 지정한다.

SELECT 컬럼명
FROM 테이블명
WHERE 검색조건
ORDER BY 정렬컬럼 ASC 또는 DESC;
  • ASC: 오름차순. 생략하면 기본값으로 적용된다.
  • DESC: 내림차순.

ORDER BY가 없으면 결과 행의 순서를 보장하지 않는다. 문자열 정렬은 데이터베이스의 문자 정렬 규칙에 영향을 받는다.

5.1 하나의 컬럼으로 정렬

실습: 도서를 이름순으로 검색한다.

SELECT *
FROM Book
ORDER BY bookname ASC;

5.2 여러 컬럼으로 정렬

실습: 가격 오름차순으로 검색하고, 가격이 같으면 도서이름 오름차순으로 정렬한다.

SELECT *
FROM Book
ORDER BY price ASC, bookname ASC;

첫 번째 컬럼이 우선 정렬 기준이다. 첫 번째 값이 같을 때 두 번째 컬럼을 비교한다.

실습: 가격 내림차순으로 검색하고, 가격이 같으면 출판사 오름차순으로 정렬한다.

SELECT *
FROM Book
ORDER BY price DESC, publisher ASC;

정렬 방향은 각 컬럼에 따로 적용된다.

6. 집계 함수

집계 함수는 여러 행의 값을 모아 합계, 평균, 개수, 최솟값, 최댓값 등을 계산한다.

함수의미예시
SUM 값의 합계 SUM(saleprice)
AVG 값의 평균 AVG(saleprice)
COUNT 행 또는 NULL이 아닌 값의 개수 COUNT(*), COUNT(saleprice)
MIN 최솟값 MIN(saleprice)
MAX 최댓값 MAX(saleprice)

SUM, AVG, MIN, MAX와 COUNT(컬럼)은 NULL을 제외하고 계산한다. COUNT(*)는 컬럼의 NULL 여부와 관계없이 행을 센다.

같은 SELECT 문의 WHERE에는 그 단계에서 계산하는 집계 함수를 직접 사용할 수 없다. WHERE는 집계 전에 개별 행을 검사하며, 집계 결과의 조건은 HAVING에서 지정한다.

6.1 SUM과 결과 컬럼의 별칭

실습: 고객이 주문한 도서의 총판매액을 구한다.

SELECT SUM(saleprice) AS 총매출
FROM Orders;

자료의 샘플 데이터 기준 결과는 다음과 같다.

총매출
118000

AS는 결과 컬럼에 별칭을 부여한다. 별칭은 결과에 표시되는 이름을 바꾸며 원본 테이블의 컬럼명을 변경하지 않는다.

6.2 특정 고객의 총판매액

실습: 고객번호가 2인 고객의 총판매액을 구한다.

SELECT SUM(saleprice) AS 총매출
FROM Orders
WHERE custid = 2;

먼저 고객번호가 2인 주문을 선택한 뒤, 선택된 주문의 판매가격을 합산한다.

총매출
15000

샘플 데이터에서 해당 고객의 판매가격은 8,000원과 7,000원이다.

6.3 여러 집계 함수 사용

실습: 전체 주문의 총판매액, 평균 판매가격, 최저 판매가격, 최고 판매가격을 구한다.

SELECT SUM(saleprice) AS 총판매액,
       AVG(saleprice) AS 평균판매가격,
       MIN(saleprice) AS 최저판매가격,
       MAX(saleprice) AS 최고판매가격
FROM Orders;
총판매액평균판매가격최저판매가격최고판매가격
118000 11800 6000 21000

평균의 소수점 표시 형식은 컬럼 자료형과 클라이언트에 따라 달라질 수 있다.

6.4 COUNT(*)와 COUNT(컬럼)의 차이

실습: 마당서점의 도서 판매건수를 구한다.

SELECT COUNT(*) AS 판매건수
FROM Orders;

샘플 데이터의 주문은 10건이므로 결과는 10이다.

COUNT(*)는 전체 행을 세고, COUNT(컬럼)은 해당 컬럼이 NULL이 아닌 행만 센다.

SELECT COUNT(*) AS 전체고객수,
       COUNT(phone) AS 전화번호등록고객수
FROM Customer;

강의자료의 Customer 데이터에는 고객 5명 중 1명의 전화번호가 NULL로 표시되어 있다.

전체고객수전화번호등록고객수
5 4

NULL은 숫자 0이나 빈 문자열과 다르다. 예를 들어 값이 10000, 20000, NULL인 컬럼의 평균은 NULL을 제외한 두 값으로 계산하므로 15,000이다.

6.5 집계 함수에서 DISTINCT 사용

SELECT COUNT(DISTINCT custid) AS 주문고객수
FROM Orders;

이 쿼리는 주문 건수가 아니라 주문한 서로 다른 고객의 수를 구한다. 샘플 데이터에서 주문 고객은 고객번호 1, 2, 3, 4이므로 결과는 4이다.

SUM(DISTINCT saleprice)는 같은 판매가격을 한 번씩만 합산한다. 동일한 가격의 주문도 별개의 매출이므로, 전체 판매액을 구할 때는 SUM(saleprice)를 사용한다.

7. GROUP BY를 이용한 그룹별 집계

GROUP BY는 지정한 컬럼의 값이 같은 행을 하나의 그룹으로 묶는다. 집계 함수는 각 그룹에 대해 별도로 계산된다.

SELECT 그룹컬럼, 집계함수
FROM 테이블명
GROUP BY 그룹컬럼;

GROUP BY 없이 집계하면 전체 검색 대상에 대한 집계 결과를 구한다. GROUP BY custid를 사용하면 고객별 집계 결과를 구한다.

7.1 고객별 주문 수와 총판매액

실습: 고객별 주문 도서의 총수량과 총판매액을 구한다. 결과 컬럼은 도서수량과 총액으로 표시한다.

SELECT custid,
       COUNT(*) AS 도서수량,
       SUM(saleprice) AS 총액
FROM Orders
GROUP BY custid
ORDER BY custid;
custid도서수량총액
1 3 39000
2 2 15000
3 3 31000
4 2 33000

고객번호가 같은 주문들을 모은 뒤, 각 그룹의 행 수와 판매가격 합계를 계산한다.

이 실습 데이터는 주문 한 행을 도서 한 권의 판매로 해석하므로 COUNT(*)를 도서수량으로 표시한다. 실제 주문 테이블에 별도의 수량 컬럼이 있는 경우에는 행 수와 구매 수량이 다를 수 있다.

Orders를 대상으로 집계하므로 주문이 없는 고객번호 5는 결과에 나타나지 않는다.

7.2 SELECT 컬럼 작성 시 주의사항

그룹별 집계에서는 결과에 표시하는 일반 컬럼이 그룹 기준과 맞아야 한다.

SELECT custid, SUM(saleprice) AS 총액
FROM Orders
GROUP BY custid;

위 쿼리는 고객별 그룹을 만들고 고객번호와 총판매액을 표시한다.

반면 다음 쿼리는 한 고객의 주문에 여러 도서번호가 존재할 수 있어 문제가 된다.

-- 그룹별로 bookid 하나를 결정할 수 없는 쿼리
SELECT custid, bookid, SUM(saleprice) AS 총액
FROM Orders
GROUP BY custid;

고객번호 1의 그룹에 도서번호 1, 3, 2가 함께 존재한다면, 하나의 결과 행에 어떤 도서번호를 표시해야 하는지 정해져 있지 않다.

실습에서는 집계하지 않는 컬럼을 GROUP BY에 포함하여 작성한다. MySQL의 ONLY_FULL_GROUP_BY 설정이 활성화된 경우에는 그룹 기준으로 결정할 수 없는 일반 컬럼의 조회가 거부된다. 설정이 비활성화된 환경에서는 실행될 수 있지만, 어떤 도서번호가 선택될지 보장되지 않는다.

8. HAVING을 이용한 그룹 조건 검색

HAVING은 집계 후 만들어진 그룹을 조건에 따라 선택한다.

구분WHEREHAVING
검사 대상 개별 행 그룹
적용 시점 그룹 생성·집계 전 그룹 생성·집계 후
대표 조건 saleprice >= 8000 COUNT(*) >= 2
역할 집계에 포함할 행 선택 결과에 포함할 그룹 선택

8.1 WHERE와 HAVING을 함께 사용

실습: 판매가격이 8,000원 이상인 주문을 대상으로 고객별 도서수량을 구하되, 해당 주문이 2건 이상인 고객만 출력한다.

SELECT custid,
       COUNT(*) AS 도서수량
FROM Orders
WHERE saleprice >= 8000
GROUP BY custid
HAVING COUNT(*) >= 2
ORDER BY custid;

이 예제는 강의자료의 SQL에 따라 Orders.saleprice를 가격 조건으로 사용한다.

custid도서수량
1 2
3 2
4 2

처리 과정은 다음과 같다.

  1. Orders에서 판매가격이 8,000원 이상인 주문만 선택한다.
  2. 선택된 주문을 고객번호별로 묶는다.
  3. 각 고객의 주문 수를 계산한다.
  4. 주문 수가 2건 이상인 고객 그룹만 남긴다.
  5. 고객번호 오름차순으로 출력한다.

필터링 후 고객별 주문 수는 다음과 같다.

custid8,000원 이상 주문 수HAVING 통과 여부
1 2 통과
2 1 제외
3 2 통과
4 2 통과

따라서 결과의 도서수량은 고객의 전체 주문 수가 아니라, 판매가격 조건을 통과한 주문의 수이다.

8.2 HAVING은 COUNT 이외의 집계 조건에도 사용

추가 실습: 총판매액이 30,000원 이상인 고객을 검색한다.

SELECT custid,
       SUM(saleprice) AS 총액
FROM Orders
GROUP BY custid
HAVING SUM(saleprice) >= 30000
ORDER BY custid;
custid총액
1 39000
3 31000
4 33000

HAVING에는 SUM, AVG, MIN, MAX, COUNT 등을 이용한 조건을 작성할 수 있다. 집계 조건만 작성할 수 있는 것은 아니며 그룹 기준 컬럼의 조건도 사용할 수 있다. 또한 GROUP BY 없이 전체를 하나의 집계 그룹으로 처리하여 HAVING을 사용하는 경우도 있다.

9. SQL 작성 순서와 논리적 처리 순서

9.1 작성 순서

SELECT 컬럼명 또는 집계식
FROM 테이블명
WHERE 행조건
GROUP BY 그룹컬럼
HAVING 그룹조건
ORDER BY 정렬컬럼;

9.2 논리적 처리 순서

순서절처리 내용
1 FROM 검색 대상 테이블 결정
2 WHERE 조건을 만족하는 행 선택
3 GROUP BY 행들을 그룹으로 묶음
4 HAVING 집계 결과를 이용하여 그룹 선택
5 SELECT 결과에 표시할 컬럼과 집계값 구성
6 ORDER BY 최종 결과 정렬

이 순서는 SQL의 의미를 이해하기 위한 논리적 처리 순서이다. DBMS의 실제 물리적 실행 순서는 실행 계획에 따라 달라질 수 있다.

WHERE가 그룹별 집계보다 앞서 적용되므로 다음과 같이 같은 단계의 집계 함수를 직접 쓰면 안 된다.

-- 잘못된 예
SELECT custid, COUNT(*) AS 도서수량
FROM Orders
WHERE COUNT(*) >= 2
GROUP BY custid;

그룹별 주문 수를 검사하려면 HAVING으로 작성한다.

SELECT custid, COUNT(*) AS 도서수량
FROM Orders
GROUP BY custid
HAVING COUNT(*) >= 2;

10. 주요 문법 정리

목적문법
원하는 컬럼 검색 SELECT 컬럼 FROM 테이블
모든 컬럼 검색 SELECT * FROM 테이블
중복 제거 SELECT DISTINCT 컬럼
행 조건 검색 WHERE 조건
범위 검색 BETWEEN 하한 AND 상한
목록 포함 여부 검색 IN (값1, 값2, ...)
문자열 패턴 검색 LIKE '패턴'
여러 조건 결합 AND, OR, NOT
결과 정렬 ORDER BY 컬럼 ASC 또는 DESC
결과 컬럼 별칭 지정 식 AS 별칭
합계·평균 계산 SUM(컬럼), AVG(컬럼)
전체 행 수 계산 COUNT(*)
NULL이 아닌 값의 수 계산 COUNT(컬럼)
최솟값·최댓값 계산 MIN(컬럼), MAX(컬럼)
그룹별 집계 GROUP BY 컬럼
그룹 조건 검색 HAVING 조건


실습문제

1-(1) 도서번호가 1인 도서의 이름

SELECT bookname
FROM Book
WHERE bookid = 1;

1-(2) 가격이 20,000원 이상인 도서의 이름

SELECT bookname
FROM Book
WHERE price >= 20000;

1-(3) 박지성의 총구매액

SELECT SUM(saleprice) AS 총구매액
FROM Orders
WHERE custid = 1;

1-(4) 박지성이 구매한 도서의 수

SELECT COUNT(*) AS 구매도서수
FROM Orders
WHERE custid = 1;

2-(1) 마당서점 도서의 총개수

SELECT COUNT(*) AS 도서총개수
FROM Book;

2-(2) 마당서점에 도서를 출고하는 출판사의 총개수

SELECT COUNT(DISTINCT publisher) AS 출판사총개수
FROM Book;

2-(3) 모든 고객의 이름과 주소

SELECT name, address
FROM Customer;

2-(4) 2024년 7월 4일~7월 7일 사이에 주문받은 도서의 주문번호

SELECT orderid
FROM Orders
WHERE orderdate >= '2024-07-04'
  AND orderdate < '2024-07-08';

2-(5) 2024년 7월 4일~7월 7일 사이에 주문받은 도서를 제외한 도서의 주문번호

SELECT orderid
FROM Orders
WHERE orderdate < '2024-07-04'
   OR orderdate >= '2024-07-08';

2-(6) 성이 ‘김’ 씨인 고객의 이름과 주소

SELECT name, address
FROM Customer
WHERE name LIKE '김%';

2-(7) 성이 ‘김’ 씨이고 이름이 ‘아’로 끝나는 고객의 이름과 주소

SELECT name, address
FROM Customer
WHERE name LIKE '김%아';


소감

잊고 있었던 개념을 되짚어보는 계기가 되어 좋았다.

'데이터베이스시스템특론' 카테고리의 다른 글

2.관계데이터모델  (1) 2026.09.29
1.데이터베이스시스템  (1) 2026.09.15

관계 데이터 모델: 릴레이션, 무결성 제약조건, 관계대수

관계 데이터 모델은 데이터를 행과 열로 이루어진 릴레이션으로 표현하는 논리적 데이터 모델이다. 하나의 개체에 관한 데이터는 하나의 릴레이션에 저장하고, 릴레이션 사이의 관계는 서로를 식별할 수 있는 값을 이용해 나타낸다.

이 글에서는 관계 데이터 모델의 기본 구조와 키, 무결성 제약조건, 관계대수의 주요 연산을 정리한다.

1. 릴레이션의 구성

릴레이션(relation)은 행과 열로 구성된 테이블이다. 릴레이션의 열은 속성(attribute), 행은 튜플(tuple)이라고 한다. 파일 관리 시스템의 용어와 비교하면 릴레이션은 파일, 속성은 필드, 튜플은 레코드에 대응한다.

예를 들어 고객 릴레이션에 고객아이디, 고객이름, 나이라는 열이 있다면 이 열들이 속성이다. 각 고객의 데이터가 들어 있는 한 행은 튜플이다.

스키마와 인스턴스

릴레이션은 스키마와 인스턴스로 구분한다.

릴레이션 스키마는 릴레이션의 논리적 구조다. 릴레이션의 이름과 포함된 속성의 이름으로 정의하며, 고객(고객아이디, 고객이름, 나이)처럼 표기할 수 있다. 속성이 가질 수 있는 값의 집합을 도메인(domain), 속성의 개수를 차수(degree)라고 한다.

릴레이션 인스턴스는 스키마에 따라 실제로 저장된 데이터의 집합이다. 인스턴스에 들어 있는 튜플의 수를 카디널리티(cardinality)라고 한다.

고객 데이터가 추가되거나 삭제되면 인스턴스와 카디널리티가 달라진다. 반면 고객 릴레이션에 어떤 속성이 있는지를 정의한 스키마는 자주 바뀌지 않는다.

릴레이션의 특징

릴레이션에는 다음과 같은 특징이 있다.

  1. 속성의 원자성: 각 속성은 하나의 원자값, 즉 단일값을 가진다. 이름 속성에 여러 이름을 한꺼번에 저장하는 방식은 적합하지 않다.
  2. 속성의 무순서성: 릴레이션에서 속성의 순서에는 의미가 없다.
  3. 속성의 동일성: 하나의 속성에는 정의된 도메인에 속하는 동일한 유형의 값이 들어간다.
  4. 튜플의 유일성: 하나의 릴레이션에 완전히 동일한 튜플이 중복해서 존재할 수 없다.
  5. 튜플의 무순서성: 릴레이션에서 튜플의 순서에는 의미가 없다.

2. 키의 종류

키(key)는 릴레이션의 튜플을 구별하는 속성 또는 속성의 집합이다. 키를 구분할 때는 유일성과 최소성을 확인한다.

유일성은 모든 튜플이 서로 다른 키 값을 가져야 한다는 뜻이다. 최소성은 튜플을 구별하는 데 필요한 속성만 키에 포함해야 한다는 뜻이다.

슈퍼키와 후보키

슈퍼키(super key)는 유일성을 만족하는 속성 또는 속성의 집합이다. 고객아이디만으로 고객을 구별할 수 있다면 고객아이디는 슈퍼키다. (고객아이디, 고객이름)도 각 고객을 구별할 수 있으므로 슈퍼키다.

후보키(candidate key)는 유일성과 최소성을 모두 만족하는 키다. 고객아이디만으로 고객을 구별할 수 있다면 (고객아이디, 고객이름)에는 불필요한 고객이름이 포함돼 있으므로 후보키가 아니다. 이 경우 고객아이디가 후보키가 될 수 있다.

후보키를 판단할 때는 현재 보이는 데이터에서 값이 우연히 다르다는 점만 볼 것이 아니라, 그 속성으로 튜플을 유일하게 구별할 수 있는지도 살펴봐야 한다.

기본키와 대체키

기본키(primary key)는 후보키 중에서 기본적으로 사용하기 위해 선택한 키다. 기본키는 NULL 값을 가질 수 없으며, 각 튜플을 유일하게 식별해야 한다.

후보키가 여러 개라면 기본키로 선택되지 않은 후보키를 대체키(alternate key)라고 한다. 즉, 대체키도 유일성과 최소성을 만족하지만 기본키로 사용되지는 않은 키다.

대리키: 주문번호로 이해하기

대리키(surrogate key)는 기존 속성만으로 적절한 기본키를 정하기 어렵거나, 기본키가 여러 속성으로 구성돼 복잡한 경우에 식별을 위해 인위적으로 만든 속성이다. 기본키로 사용할 값이 보안을 필요로 하는 경우에도 대리키를 사용할 수 있다.

수업자료의 예시는 주문번호다. 주문번호는 주문을 구별할 수 있도록 새로 부여한 번호다.

주문번호                         주문고객                                                                        주문제품


1 carrot 제품 A
2 carrot 제품 B
3 apple 제품 A

이 표에서 주문고객만으로는 주문을 구별할 수 없다. carrot 고객의 주문이 두 건이기 때문이다. 주문제품만으로도 구별할 수 없다. 제품 A를 주문한 내역이 두 건이다. 고객과 제품을 묶어 사용하더라도 같은 고객이 같은 제품을 다시 주문하는 상황까지 생각하면 주문을 항상 구별할 수 있는 값으로 삼기 어렵다.

이때 주문마다 1, 2, 3처럼 별도의 주문번호를 부여하면 각 주문을 구별할 수 있다. 이 번호는 고객이나 제품의 특징을 나타내기 위해 존재하는 값이 아니라, 주문 한 건을 식별하기 위해 만든 값이다. 이것이 대리키의 핵심이다.

정리하면 기본키는 어떤 역할을 하는 키인가를 나타내고, 대리키는 그 값을 어떻게 마련했는가와 관련된 표현이다. 주문번호를 인위적으로 만들어 주문 릴레이션의 기본키로 선택했다면, 그 주문번호는 대리키이면서 기본키다.

외래키

외래키(foreign key)는 다른 릴레이션의 기본키를 참조하는 속성 또는 속성의 집합이다. 외래키를 이용해 릴레이션 사이의 관계를 표현한다.

고객과 주문 릴레이션을 예로 들면, 주문 릴레이션에 고객을 식별하는 값을 저장해 해당 주문이 어느 고객의 주문인지 나타낼 수 있다. 이때 주문 릴레이션처럼 외래키를 가진 쪽을 자식 릴레이션, 참조되는 기본키를 가진 고객 릴레이션을 부모 릴레이션이라고 한다.

외래키 속성과 참조하는 기본키 속성은 이름이 달라도 되지만 도메인은 같아야 한다. 외래키는 기본키와 달리 NULL이나 중복값을 가질 수 있다.

3. 무결성 제약조건

무결성은 데이터에 결함이 없고 정확하며 유효한 상태를 뜻한다. 데이터의 삽입·삭제·수정 이후에도 이 상태를 유지하기 위해 적용하는 규칙이 무결성 제약조건이다.

도메인 무결성

도메인 무결성 제약조건은 각 속성이 정의된 도메인에 속하는 값을 가져야 한다는 규칙이다. 데이터를 입력하거나 수정할 때 해당 속성에 허용되는 값인지 확인한다.

개체 무결성

개체 무결성 제약조건은 기본키가 NULL 값을 가지거나 중복돼서는 안 된다는 규칙이다. 기본키가 NULL이면 튜플을 식별할 수 없고, 같은 기본키 값이 여러 번 나타나면 서로 다른 튜플을 구별할 수 없다.

기본키가 여러 속성으로 구성된 복합키라면, 그 속성 중 일부도 NULL 값을 가질 수 없다. 수업자료의 학생 릴레이션 예시에서는 이미 존재하는 학번으로 학생을 추가하거나 학번을 NULL로 추가하는 경우가 거부된다.

참조 무결성

참조 무결성 제약조건은 외래키가 참조하는 관계를 올바르게 유지하기 위한 규칙이다. 자식 릴레이션의 외래키에 값이 있다면, 그 값은 부모 릴레이션에서 참조할 수 있어야 한다.

수업자료의 학생과 학과 릴레이션을 예로 들면, 학생의 학과코드에 3001을 넣으려는데 학과 릴레이션에 3001이라는 학과코드가 없다면 삽입이 거부된다. 존재하지 않는 학과를 참조하게 되기 때문이다. 학과 릴레이션에 해당 학과를 먼저 추가한 뒤에는 참조할 수 있다.

외래키에 NULL을 허용하도록 정의했다면 학과코드를 NULL로 두는 것은 가능하다. NULL은 부모 릴레이션에 존재하지 않는 값을 지정한 경우와 구분된다.

부모 릴레이션의 데이터를 삭제할 때도 참조 무결성을 확인해야 한다. 예를 들어 학생들이 참조하고 있는 학과를 삭제하면, 학생 릴레이션의 학과코드가 가리킬 대상이 사라질 수 있다. 수업자료에서는 이를 처리하는 옵션으로 다음을 제시한다.

  • RESTRICT / NO ACTION: 부모 데이터의 삭제를 거부한다.
  • CASCADE: 부모 데이터를 삭제할 때 자식 데이터도 함께 삭제한다.
  • SET NULL / SET DEFAULT: 자식의 외래키를 NULL 또는 기본값으로 변경한다.

4. 관계대수

관계대수는 릴레이션에서 원하는 결과를 얻기 위해 수행할 연산의 과정을 표현하는 방법이다. 하나 이상의 릴레이션에 연산을 적용하며, 그 결과도 릴레이션이다. 따라서 어떤 연산의 결과에 다른 연산을 이어서 적용할 수 있다. 이를 폐쇄 특성이라고 한다.

집합 연산

릴레이션은 튜플의 집합이므로 집합 연산을 적용할 수 있다. 다만 합집합, 교집합, 차집합을 수행하려면 두 릴레이션이 합병 가능해야 한다. 두 릴레이션의 차수가 같고, 서로 대응되는 속성의 도메인이 같아야 한다.

  • 합집합 R ∪ S: R 또는 S에 속하는 모든 튜플을 반환한다.
  • 교집합 R ∩ S: R과 S에 공통으로 속하는 튜플을 반환한다.
  • 차집합 R − S: R에는 있지만 S에는 없는 튜플을 반환한다.

합집합과 교집합은 R과 S의 순서를 바꿔도 결과가 같다. 차집합은 순서에 따라 의미가 달라지므로 R − S와 S − R을 구분해야 한다.

카티션 프로덕트(cartesian product)는 R의 각 튜플을 S의 모든 튜플과 연결해 가능한 조합을 만든다. R과 S의 튜플이 각각 3개라면 결과에는 3 × 3 = 9개의 튜플이 생긴다. 결과의 차수는 두 릴레이션의 차수를 더한 값이다.

셀렉션과 프로젝션

셀렉션(selection)은 릴레이션에서 조건을 만족하는 튜플, 즉 행을 추출한다. σ조건식(릴레이션)으로 나타낸다. 조건식에는 비교 연산자와 논리 연산자를 사용할 수 있다. 수업자료의 ‘등급이 gold이고 적립금이 2000 이상인 고객’을 찾는 것이 셀렉션의 예다.

프로젝션(projection)은 릴레이션에서 필요한 속성, 즉 열을 추출한다. π속성리스트(릴레이션)으로 나타낸다. 결과에 동일한 튜플이 생기면 중복 없이 한 번만 표시한다.

‘가격이 8,000원 이하인 도서의 이름과 출판사’를 구할 때는 먼저 가격 조건에 맞는 튜플을 셀렉션하고, 그 결과에서 도서이름과 출판사 속성을 프로젝션할 수 있다.

조인

조인(join)은 두 릴레이션에서 관련 있는 튜플을 연결하는 연산이다. 수업자료에서는 여러 종류의 조인을 다룬다.

세타조인은 =, ≠, <, > 등의 비교 연산자를 조건으로 사용한다. 세타조인 중 =를 사용하는 것이 동등조인이다. 동등조인 결과에는 양쪽 릴레이션의 조인 속성이 모두 나타난다.

자연조인은 값이 같은 튜플을 연결하고, 결과에서 중복되는 조인 속성을 제거한다. 공통 속성이 여러 개라면 해당 속성들의 값이 같은 튜플을 연결한다.

외부조인은 조인 조건에 맞지 않는 튜플도 결과에 포함하고, 대응되는 값이 없는 속성에는 NULL을 채운다. 왼쪽 릴레이션의 모든 튜플을 포함하는 왼쪽 외부조인, 오른쪽 릴레이션의 모든 튜플을 포함하는 오른쪽 외부조인, 양쪽 릴레이션의 모든 튜플을 포함하는 완전 외부조인이 있다.

세미조인은 두 릴레이션을 연결한 뒤 한쪽 릴레이션의 결과만 반환한다. 수업자료의 ‘주문한 적이 있는 고객의 데이터만 보기’가 예다. 주문 내역을 이용해 주문 여부를 확인하지만, 결과에는 고객 쪽 데이터만 남긴다.

디비전

디비전(division)은 주어진 조건을 모두 만족하는 대상을 찾을 때 사용하는 연산이다. R ÷ S로 나타내며, R은 S의 모든 속성을 포함해야 한다.

수업자료에서는 학생이 수강한 과목을 담은 StudentCourse와 전공 필수 과목을 담은 RequiredCourses를 사용한다. 이때 StudentCourse ÷ RequiredCourses는 전공 필수 과목을 모두 수강한 학생을 구한다.

두 릴레이션을 조인하면 학생이 수강한 과목 중 필수 과목과 일치하는 내역을 볼 수 있지만, 필수 과목을 일부만 수강한 학생도 나타날 수 있다. 디비전은 필수 과목 전체를 수강했는지를 확인한다는 차이가 있다.

5. 관계대수와 SQL

관계대수의 연산은 SQL 구문과도 연결해서 볼 수 있다. 셀렉션은 조건에 맞는 행을 찾는 WHERE, 프로젝션은 필요한 열을 선택하는 SELECT에 대응한다. 합집합은 UNION, 카티션 프로덕트는 CROSS JOIN, 조인은 JOIN ... ON으로 표현할 수 있다. ‘모든 조건을 만족하는 대상’을 찾는 디비전은 NOT EXISTS를 이용해 표현할 수 있다.

특정 고객이 주문한 제품을 찾는 경우에는 고객 릴레이션에서 이름이 일치하는 튜플을 선택하고, 주문 릴레이션과 조인한 뒤, 주문제품 속성만 추출하는 순서로 관계대수식을 구성할 수 있다.

소감

대리키가 이해가 잘 안가서, 추가 설명을 더 찾아봤다. SQL말고 관계대수 표현은 낯설어서 수업할때는 이해가 갔는데 막상 다시보니 어렵게 느껴졌다.


문제풀이


(3) 주문이 있는 판매원의 이름

정답

π_salesperson(Order)

풀이: 주문 한 건에는 그 주문을 담당한 판매원의 이름이 salesperson에 들어 있다. 따라서 Order에서 이 열만 추출하면 된다. 같은 판매원이 여러 건을 수주했더라도 관계대수의 프로젝션 결과에는 이름이 중복해서 나오지 않는다.

(4) 주문이 없는 판매원의 이름

정답

π_name(Salesperson) - π_salesperson(Order)

풀이: 전체 판매원 이름에서 주문에 한 번이라도 등장한 판매원 이름을 빼면 된다. 왼쪽과 오른쪽이 모두 ‘판매원 이름 한 열’이므로 차집합으로 표현할 수 있다.

(5) 고객 ‘홍길동’의 주문을 수주한 판매원의 나이

정답

π_age(Salesperson ⋈_{Salesperson.name = Order.salesperson} σ_{custname = '홍길동'}(Order))

풀이: 먼저 Order에서 custname이 ‘홍길동’인 주문을 고른다. 그 주문의 salesperson과 Salesperson.name을 연결하면 담당 판매원 정보를 찾을 수 있다. 마지막으로 age만 추출한다.

(6) 나이가 25세인 판매원에게 주문한 고객의 city 값

정답

π_city((σ_{age = 25}(Salesperson) ⋈_{Salesperson.name = Order.salesperson} Order) ⋈_{Order.custname = Customer.name} Customer)

풀이: 나이가 25세인 판매원을 먼저 선택한다. Order와 연결해 그 판매원이 받은 주문을 찾고, 다시 Customer와 연결해 주문한 고객을 찾는다. 최종적으로 고객의 city를 추출한다.

(7) 판매원 이름과 그 판매원에게 주문한 고객 이름 — 주문이 없는 판매원도 포함

정답

π_{Salesperson.name, Order.custname}(Salesperson ⟕_{Salesperson.name = Order.salesperson} Order)

풀이: 왼쪽 외부조인을 사용해야 한다. Salesperson을 왼쪽에 두면 주문이 없는 판매원도 결과에 남는다. 그런 판매원은 대응되는 주문이 없으므로 고객 이름 자리인 Order.custname이 NULL로 표시된다. 일반 조인을 쓰면 주문이 없는 판매원이 결과에서 빠진다.


연습문제 10개

풀이 및 해설

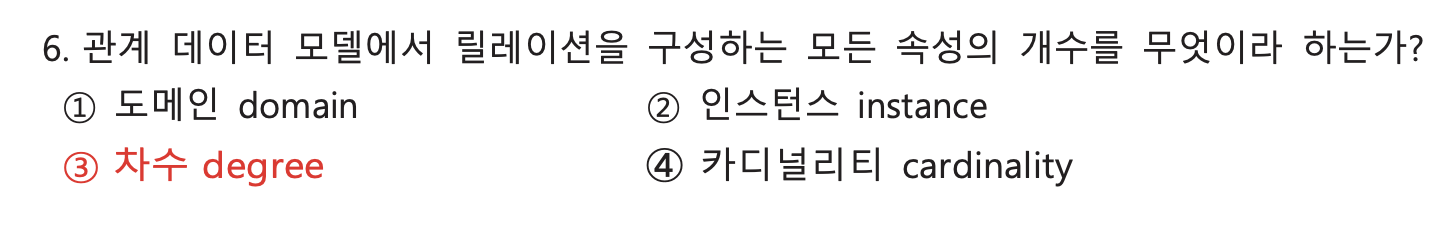
릴레이션에서 차수(degree)는 릴레이션을 구성하는 속성(attribute)의 개수를 의미한다.


풀이 및 해설

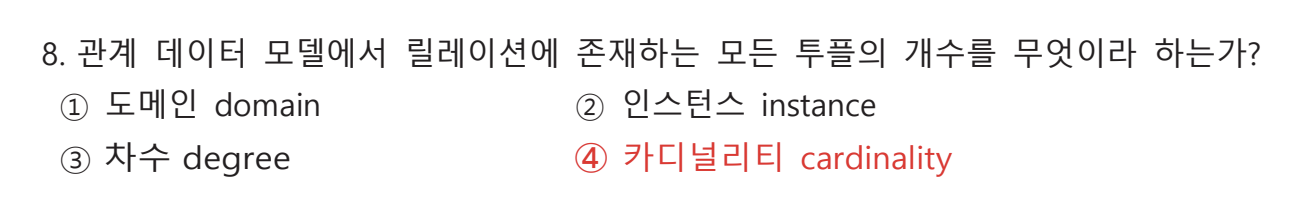
튜플의 개수는 카디널리티 이다.


풀이 및 해설

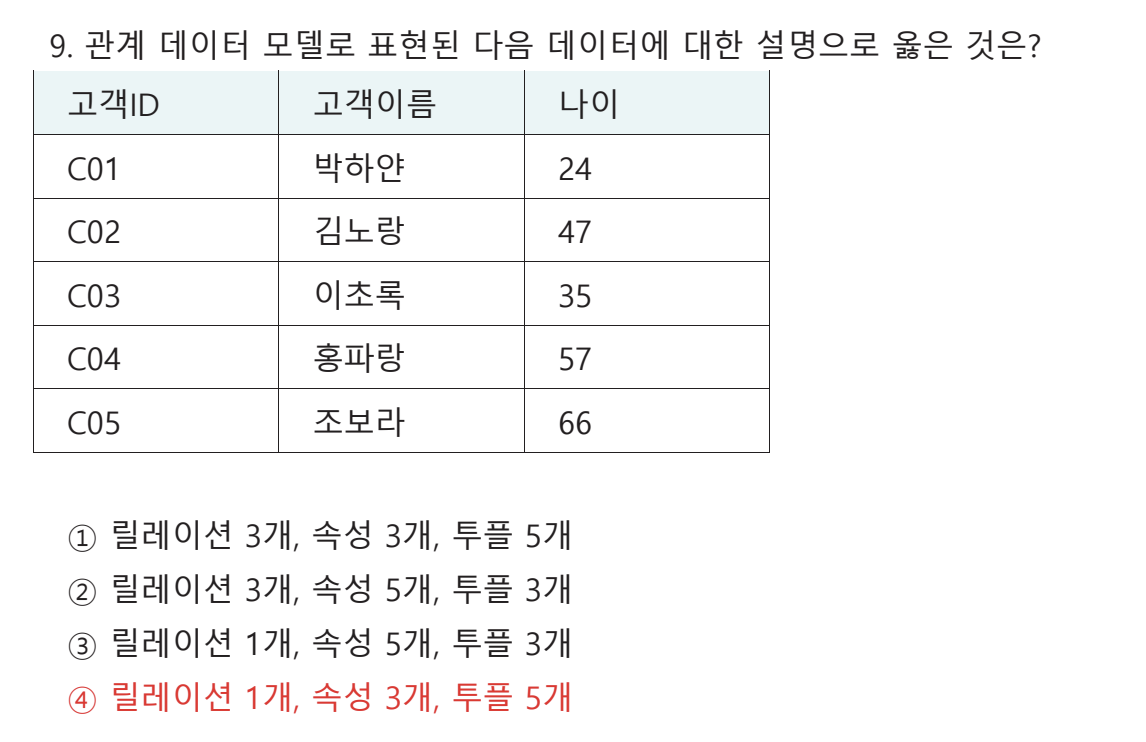
표 전체가 하나의 릴레이션이므로

릴레이션 = 1개이다.

열을 보면

고객ID / 고객이름 / 나이

총 3개이므로 속성 = 3개이다.

실제 데이터 행은 C01부터 C05까지 총 5개이므로

튜플 = 5개이다.

따라서

릴레이션 1개 + 속성 3개 + 튜플 5개

이므로 정답은 ④번이다.


풀이 및 해설

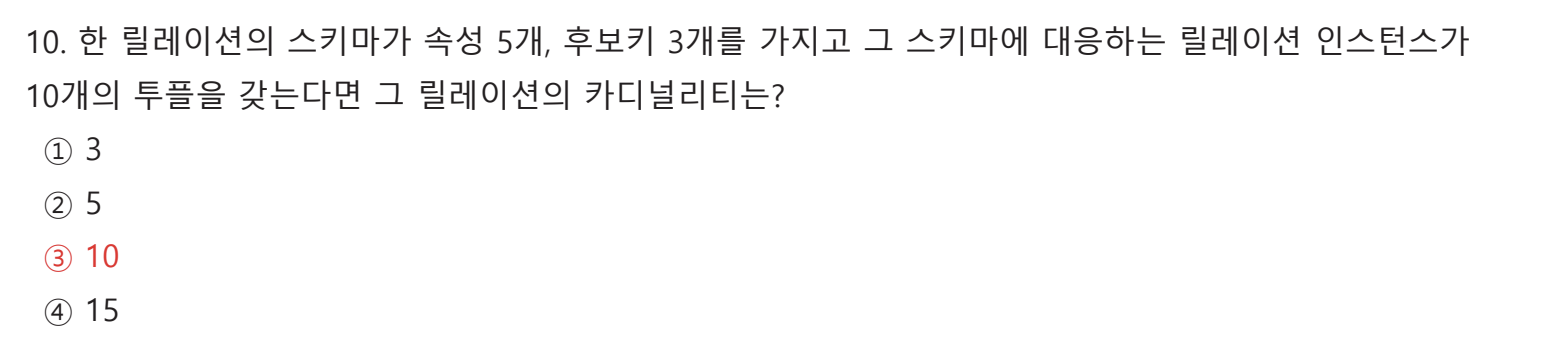
여기서 카디널리티는 튜플의 개수를 의미한다.

따라서 후보키가 몇 개인지, 속성이 몇 개인지는 카디널리티를 구할 때 관계없다.

튜플이 10개라고 했으므로 카디널리티 = 10이다. 따라서 정답은 ③번이다.


풀이 및 해설

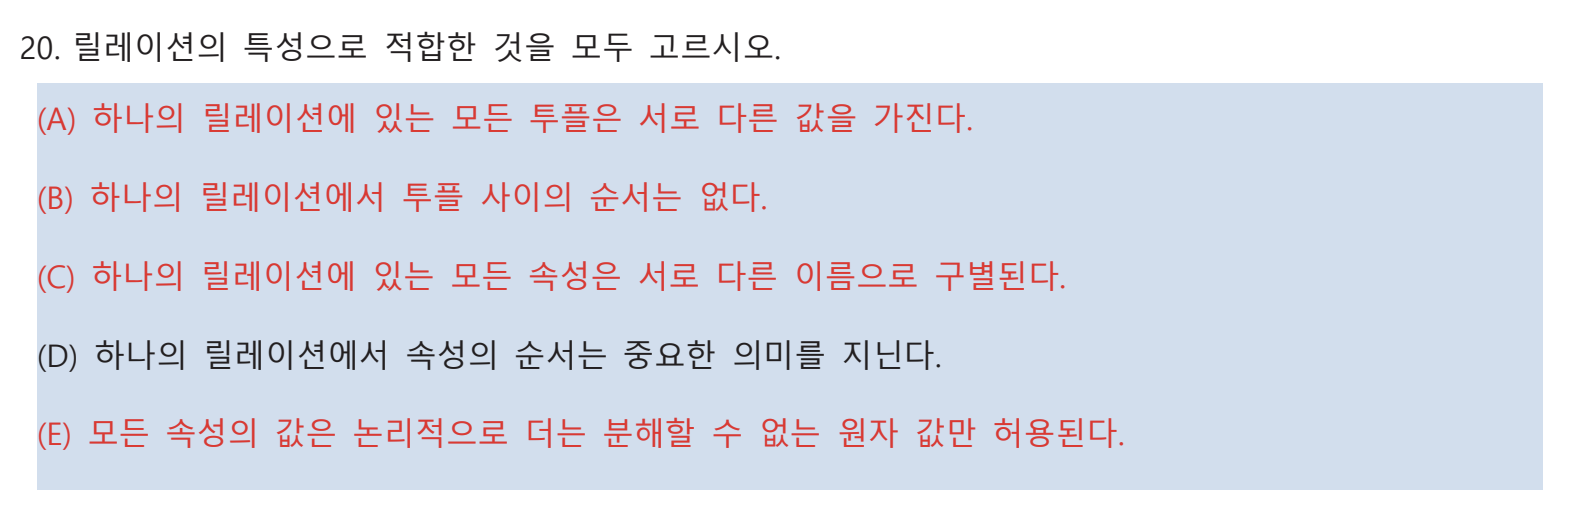
(A) O

릴레이션에서는 동일한 튜플이 중복해서 존재하지 않는다.

(B) O

릴레이션에서 튜플의 순서는 의미가 없다.

어떤 튜플이 첫 번째 행에 있다고 해서 두 번째 행보다 더 중요하다는 의미가 아니다.

(C) O

하나의 릴레이션 안에서 각각의 속성은 이름을 통해 구별된다.

(D) X

속성의 순서는 중요한 의미를 갖지 않는다.

예를 들어 학생(학번, 이름, 학과)와 학생(이름, 학과, 학번)

처럼 순서를 바꿨다고 해서 데이터 자체의 의미가 달라지는 것은 아니다.

(E) O

관계 데이터 모델에서 속성값은 원자 값(atomic value)을 가져야 한다.

따라서 정답은 (A), (B), (C), (E)이다.


풀이 및 해설

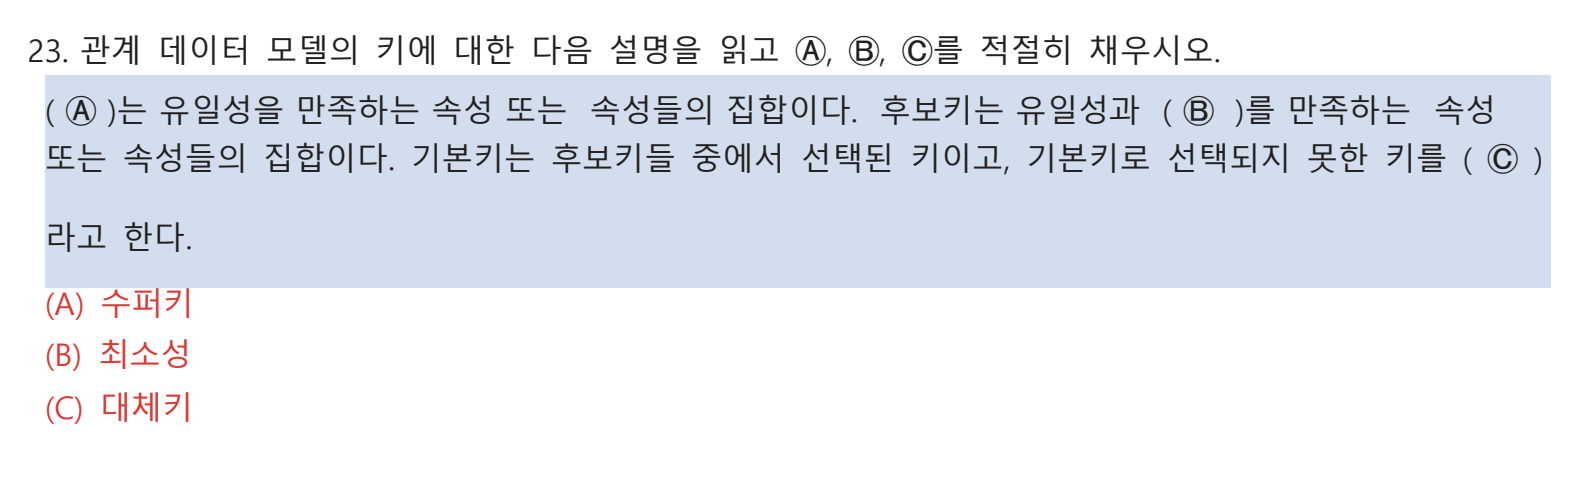
먼저 슈퍼키는 튜플을 유일하게 구별할 수 있는 속성 또는 속성의 집합이다.

즉, 유일성을 만족한다.

그런데 슈퍼키 중에서 불필요한 속성을 제거하고도 튜플을 구별할 수 있는 키를 후보키라고 한다.

따라서 후보키는 유일성 + 최소성을 만족해야 한다.

후보키가 여러 개라면 그중 하나를 선택하여 기본키(primary key)로 사용한다.

그리고 기본키로 선택되지 않은 나머지 후보키를 대체키(alternate key)라고 한다.

따라서

슈퍼키 → 유일성

후보키 → 유일성 + 최소성

기본키 → 후보키 중 선택

대체키 → 후보키 중 기본키로 선택되지 않은 키 이다.


풀이 및 해설

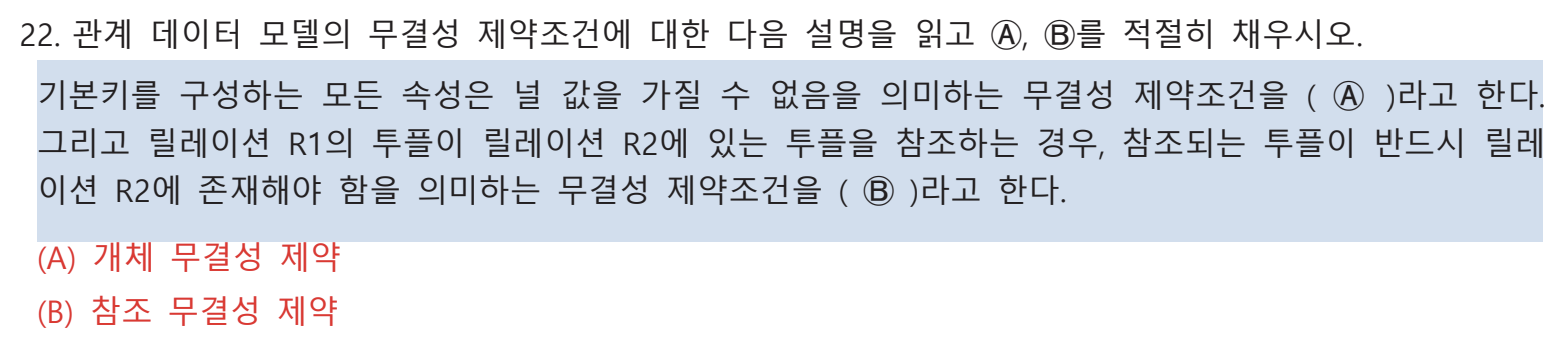
개체 무결성은 기본키와 관련된 규칙이다.

기본키는 각각의 튜플을 식별해야 하기 때문에 기본키가 NULL이면 안 된다.

따라서 기본키는 NULL 값을 가질 수 없다 → 개체 무결성이다.

반면 참조 무결성은 외래키와 관련된다.

예를 들어

학생(학번, 이름, 학과코드)

학과(학과코드, 학과명)

이라는 두 릴레이션이 있고 학생의 학과코드가 학과 릴레이션을 참조한다고 생각해보자.

학생의 학과코드가 C001이라면 학과 릴레이션에도 C001이 실제로 존재해야 한다.

존재하지 않는 학과코드를 학생이 참조하면 안 된다.

따라서 기본키 NULL 금지 → 개체 무결성 외래키의 올바른 참조 → 참조 무결성으로 구분하면 된다.


풀이 및 해설

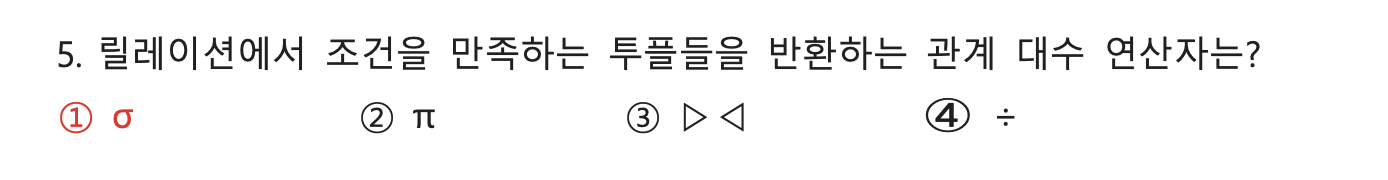
셀렉트 연산은 릴레이션에서 주어진 조건을 만족하는 튜플을 선택하는 연산이다.


풀이 및 해설

PROJECT 연산은 릴레이션에서 원하는 속성만 선택하는 연산이다.

예를 들어 학생(학번, 이름, 학과, 학년)

이라는 릴레이션에서 이름과 학과만 필요하다면 PROJECT 연산을 사용한다.


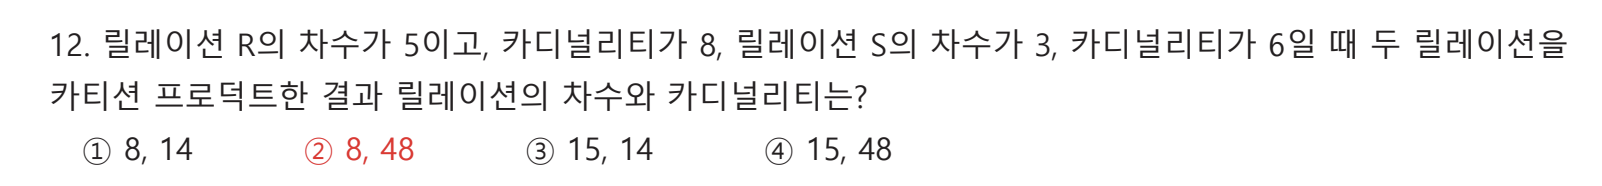
풀이 및 해설

카티션 프로덕트는 두 릴레이션의 모든 튜플을 서로 조합하는 연산이다.

먼저 차수부터 계산한다.

R의 차수 = 5
S의 차수 = 3

카티션 프로덕트를 하면 두 릴레이션의 속성이 합쳐지므로

5 + 3 = 8

따라서 결과 릴레이션의 차수는 8이다.

이번에는 카디널리티를 계산한다.

R의 카디널리티 = 8
S의 카디널리티 = 6

R의 튜플 하나마다 S의 6개 튜플이 모두 결합한다.

따라서 8 × 6 = 48 이 된다.

즉, 차수 = 5 + 3 = 8 카디널리티 = 8 × 6 = 48

따라서 정답은 ② 8, 48이다.

'데이터베이스시스템특론' 카테고리의 다른 글

3.SQL 기초(1)  (1) 2026.10.06
1.데이터베이스시스템  (1) 2026.09.15

1 데이터와 정보 그리고 지식

데이터베이스를 이해하려면 먼저 데이터, 정보, 지식을 구분해야 한다. 세 개념은 서로 연결되어 있지만 의미와 활용 단계가 다르다.

구분 의미
데이터 현실 세계에서 관찰하거나 측정하여 수집한 정량적 또는 정성적 값
정보 데이터에 맥락과 의미를 부여해 의사 결정에 활용할 수 있도록 처리한 결과
지식 정보를 경험과 학습을 바탕으로 해석하여 판단과 문제 해결에 활용할 수 있는 이해

DB에 저장된 값은 데이터, 그 데이터를 조회/분석/가공 하면 정보, 정보를 해석/축적하면 지식


데이터의 형태와 특성

데이터는 구조에 따라 정형, 반정형, 비정형 데이터로 나눌 수 있다. 행과 열이 명확한 관계형 테이블이나 엑셀 자료는 정형 데이터, 키와 값의 구조를 가지지만 형식이 유연한 JSON과 XML은 반정형 데이터, 이미지·영상·자유 형식 문서는 비정형 데이터에 해당한다.

또한 특성에 따른 분류로는 범주형 데이터와 수치형 데이터로 구분할 수 있다. 범주형 데이터는 종류나 집단을 나타내므로 산술 연산보다 빈도와 비율을 살펴보는 데 적합하다. 수치형 데이터는 크기 비교와 산술 연산이 가능해 평균, 분산, 추세 분석 등에 활용된다. 데이터의 특성에 따라 적합한 분석 방법을 선택할 수 있다.


2 데이터베이스란 무엇인가

데이터베이스는 여러 사용자가 공유할 수 있도록 통합하여 저장한 운영 데이터의 집합이다. 이 정의에는 네 가지 중요한 개념이 포함된다.

공유 데이터: 특정 조직의 여러 사용자가 함께 소유하고 이용하는 데이터

통합 데이터: 불필요한 중복은 줄이고 필요한 중복만 허용하는 데이터

저장 데이터: 컴퓨터가 접근할 수 있는 저장 매체에 보관된 데이터

운영 데이터: 조직의 주요 기능을 수행하기 위해 지속적으로 필요한 데이터

데이터베이스는 실시간 접근성, 계속적인 변화, 동시 공유, 내용에 의한 참조라는 특성도 가진다.

실시간 접근성 : 수초 내에 질의 응답을 제공하는 것

계속적인 변화 : 삽입, 삭제, 갱신을 통해 항상 최신 상태를 유지하는 것

동시 공유 : 여러 사용자가 서로 다른 목적으로 동시에 동일 데이터를 이용할 수 있는 것

내용에 의한 참조: 데이터의 물리적 주소나 위치가 아니라 사용자가 요구하는 값으로 참조하는 것


3 데이터베이스 시스템의 핵심 구성

구성 요소 역할
데이터베이스 통합·공유되는 운영 데이터를 실제로 저장한다.
DBMS 사용자와 데이터베이스 사이에서 저장, 조회, 변경, 보안, 복구를 관리한다.
데이터 모델 현실의 데이터를 데이터베이스 구조로 변환하는 논리적 기준을 제공한다.
사용자 일반 사용자, SQL 사용자, 응용 프로그래머, DBA 등 목적에 따라 데이터를 활용하고 관리한다.
인터페이스 SQL과 응용 프로그램을 통해 사용자 요청을 DBMS에 전달한다.


4 데이터베이스 시스템의 발전

1단계 : 동네서점

2단계 : 초기 전산화(+로컬 컴퓨터)

3단계 : 데이터베이스 시스템 도입(+원격통신)

4단계 : 홈페이지 구축(+인터넷)

5단계 : 인터넷 쇼핑몰로 확장


5 파일 시스템과 DBMS의 차이

초기 프로그램은 데이터를 프로그램 내부의 배열이나 개별 파일에 저장했다. 데이터가 적을 때는 간단하지만, 데이터 구조가 바뀌거나 여러 프로그램이 같은 파일을 함께 사용할 때 문제가 커진다. 데이터가 중복되고 서로 다른 값으로 갱신될 수 있으며, 보안·공유·복구 기능도 각 프로그램이 따로 구현해야 하기 때문이다.

DBMS를 사용하면 데이터와 응용 프로그램을 분리해 관리할 수 있다. 응용 프로그램은 저장 위치나 세부 형식을 직접 다루는 대신 DBMS에 SQL로 요청한다. 이 구조는 데이터 독립성과 일관성을 높이고, 중복을 통제하며, 프로그램 개발과 유지보수를 단순하게 한다.

항목 파일 시스템 DBMS
데이터 정의 응용 프로그램 DBMS
데이터 저장 파일시스템 데이터베이스
데이터 접근 방법 응용 프로그램이 파일에 직접 접근함 응용 프로그램이 DBMS에 파일 접근을 요청함
사용 언어 자바, C++, C등 자바, C++, C등과 SQL
CPU/주기억장치 사용 적음 많음


DBMS의 장점과 한계

DBMS의 장점은 데이터 중복 통제, 데이터 독립성, 동시 공유, 보안 향상, 무결성 유지, 표준화, 장애 복구, 응용 프로그램 개발 비용 절감으로 정리할 수 있다. 반면 도입 비용이 들고 백업과 장애 복구가 복잡하며, 중앙 집중 관리에 따른 취약점도 존재한다. 대규모 동시 접속이나 복잡한 질의에서는 성능 저하가 발생할 수 있어 설계, 운영, 최적화와 튜닝을 담당할 전문 인력이 필요하다.


6 DBMS와 정보 시스템의 발전

정보 시스템은 개별 파일 중심의 처리에서 데이터베이스 시스템, 웹 데이터베이스 시스템, 분산 데이터베이스 시스템으로 발전해 왔다. 초기에는 한 컴퓨터 안에서 도서 검색이나 매출 관리를 처리했다면, 통신 기술과 인터넷의 발전 이후에는 본점과 지점, 거래처와 고객까지 연결되었다. 오늘날에는 여러 서버와 지역에 데이터를 분산하여 더 많은 사용자의 요청을 처리한다.

DBMS 자체도 데이터 표현 방식과 요구에 따라 발전했다. 1세대의 계층형·네트워크 DBMS는 포인터를 이용해 관계를 표현했고, 2세대의 관계형 DBMS는 데이터를 테이블 형태로 표현하여 이해와 개발을 쉽게 했다. 이후 객체지향 개념을 결합한 객체지향·객체관계 DBMS가 등장했으며, 대규모 분산 환경과 비정형 데이터 처리를 위해 NoSQL과 NewSQL이 발전했다.

세대 대표 유형 핵심 특징
1세대 계층형, 네트워크형 트리나 그래프 구조와 포인터로 관계 표현
2세대 관계형 행과 열로 구성된 테이블과 속성값으로 관계 표현
3세대 객체지향, 객체관계형 객체 식별자와 상속·캡슐화 개념 활용
4세대 NoSQL, NewSQL 유연한 구조와 분산 확장성, 관계형의 안정성 결합


7 데이터베이스 시스템의 구성

- 데이터베이스/DBMS/데이터 모델

- 데이터베이스 사용자

- 인터페이스

   * 데이터베이스 언어(SQL)

   * 응용프로그램

- 시스템 카탈로그

 데이터 베이스의 모든 정보를 담고 있는 종합 저장소

 데이터 사전 + 데이터 디렉토리

- 데이터 사전

 메타데이터의 개념 : 데이터에 관한 데이터, 데이터베이스의 구조와 뜻을 설명하는 메타데이터 저장소

 특징 : 스키마, 테이블, 뷰, 인덱스, 제약조건, 사용자 권한 정보등이 저장됨

 읽기 전용 : DBMS가 스스로 생성하고 갱신함. 사용자는 일반 테이블처럼 select로 조회는 가능. 직접 변경은 불가능.

- 데이터 디렉터리

 사용자와 DBMS는 모두 접근 가능한 영역(사전)과 시스템(DBMS)만 내부적으로 접근하는 영역(디렉터리)의 차이

 데이터 디렉토리 : 데이터 사전에 있는 내용에 실제로 접근하는 위치와 경로 정보를 관리하는 시스템


8 SQL과 데이터베이스 사용자

SQL은 사용자와 DBMS가 의사소통하는 언어다. SQL은 용도에 따라 데이터 정의어, 데이터 조작어, 데이터 제어어로 구분한다.

DDL: 테이블 등 데이터베이스 구조를 정의. CREATE, ALTER, DROP 등

DML: 데이터를 검색·삽입·수정·삭제. SELECT, INSERT, UPDATE, DELETE 등

DCL: 데이터 사용 권한과 내부 규칙을 관리. GRANT, REVOKE 등

가장 기본적인 데이터 조회는 SELECT-FROM-WHERE 구조로 이루어진다. SELECT는 확인할 열, FROM은 대상 테이블, WHERE는 행을 선택할 조건을 지정한다. 데이터베이스를 직접 사용하는 정도는 역할마다 다르다. 일반 사용자는 응용 프로그램을 통해 데이터를 이용하고, SQL 사용자는 필요한 업무를 질의로 처리한다. 응용 프로그래머는 사용자가 이용할 프로그램을 만들며, DBA는 데이터베이스의 구조, 권한, 보안, 성능과 운영을 종합적으로 관리한다.


9 데이터 모델과 관계 표현

데이터 모델은 현실 세계의 데이터를 데이터베이스 구조로 변환하기 위한 논리적 가이드라인이다. 데이터가 어떻게 구조화되고 저장되며 서로 어떤 관계를 가지는지를 결정한다. 계층형과 네트워크형 모델은 포인터로 관계를 표현하므로 실행 속도는 빠를 수 있지만 프로그램이 구조에 강하게 의존한다. 관계형 모델은 공통 속성값을 이용해 테이블 사이의 관계를 표현하므로 개념이 단순하고 개발이 쉽다. 객체 모델은 객체 식별자를 사용하며 객체지향 언어의 상속과 캡슐화 개념을 활용할 수 있다. 현재 가장 널리 사용되는 것은 관계 데이터 모델이다.


10 3단계 스키마 구조와 데이터 독립성

ANSI/SPARC가 제안한 3단계 데이터베이스 구조는 데이터베이스를 바라보는 관점을 외부 단계, 개념 단계, 내부 단계로 나눈다. 이 구분의 핵심 목적은 복잡한 저장 구조를 사용자에게 그대로 노출하지 않고, 각 단계의 변경이 다른 단계에 미치는 영향을 줄이는 데 있다.

단계 관점 스키마의 의미
외부 단계 개별 사용자 사용자나 응용 프로그램이 필요로 하는 데이터의 논리적 부분. 여러 외부 스키마가 존재할 수 있다.
개념 단계 조직 전체 전체 데이터베이스의 논리 구조, 관계, 제약조건, 보안 정책과 접근 권한을 정의한다. 일반적으로 하나만 존재한다.
내부 단계 저장 장치 레코드 구조, 필드 크기, 인덱스, 배치와 압축 등 실제 저장 방법을 정의한다. 하나의 내부 스키마가 존재한다.


스키마와 인스턴스

스키마는 데이터베이스에 저장되는 데이터 구조와 제약조건을 정의한 설계도다. 반면 인스턴스는 특정 시점에 스키마에 따라 실제로 저장된 값이다. 학생 테이블의 열 이름과 자료형은 스키마이고, 각 학생의 학번·이름·학년 값은 인스턴스라고 볼 수 있다. 스키마는 비교적 안정적이지만 인스턴스는 데이터의 삽입, 수정, 삭제에 따라 계속 변한다.


논리적 데이터 독립성과 물리적 데이터 독립성

DBMS는 외부 스키마와 개념 스키마 사이, 개념 스키마와 내부 스키마 사이의 대응 관계를 매핑으로 관리한다. 이 매핑 덕분에 하위 단계가 변경되어도 상위 단계에 미치는 영향을 줄일 수 있다.

논리적 데이터 독립성: 개념 스키마가 변경되어도 외부 스키마와 응용 프로그램이 영향을 받지 않도록 하는 성질. 예를 들어 테이블에 새로운 속성을 추가해도 기존 사용자의 조회가 그대로 동작하도록 할 수 있음.

물리적 데이터 독립성: 내부 저장 구조가 변경되어도 개념 스키마가 영향을 받지 않도록 하는 성질. 예를 들어 인덱스 구조나 파일 배치 방식을 바꾸어도 사용자에게 보이는 테이블 구조는 동일하게 유지됨.


느낀점

현업에서 데이터베이스를 쓰기 때문에 익숙해서 놓치고 있던 개념들을 한번씩 더 훑고가는 계기가 되어 유익했다.

기존에는 RDBMS만 썼었는데, 다양한 DBMS를 경험해보고 장단점을 체험해보고 싶다


<문제풀이>

1) 다음 중 데이터베이스의 4대 특성에 해당하지 않는 것은?

① 실시간 접근성

② 계속적인 변화

③ 동시 공유

④ 물리적 주소에 의한 참조


2) 파일 시스템과 비교했을 때 DBMS를 사용하는 장점으로 가장 적절한 것은?

① 데이터 중복을 증가시킨다.
② 데이터 독립성을 확보할 수 있다.
③ 모든 장애를 자동으로 방지한다.
④ 전문적인 관리가 필요하지 않다.


3) SQL에서 테이블을 생성하거나 구조를 변경할 때 사용하는 언어는 무엇인가?

① 데이터 정의어 DDL
② 데이터 조작어 DML
③ 데이터 제어어 DCL
④ 데이터베이스 관리 시스템 DBMS


4) 다음 중 ‘정보’에 대한 설명으로 가장 적절한 것은?

① 현실 세계에서 관찰하거나 측정하여 수집한 값이다.
② 데이터에 맥락과 의미를 부여하여 의사결정에 활용할 수 있도록 처리한 결과물이다.
③ 경험과 학습을 통해 축적되어 문제 해결에 직접 활용되는 이해이다.
④ 데이터베이스의 구조와 제약조건을 정의한 것이다.


5) 인덱스 구조나 데이터의 물리적인 저장 방식을 변경해도 개념 스키마가 영향을 받지 않는 성질은 무엇인가?

① 논리적 데이터 독립성
② 데이터 무결성
③ 동시 공유성
④ 물리적 데이터 독립성


'데이터베이스시스템특론' 카테고리의 다른 글

3.SQL 기초(1)  (1) 2026.10.06
2.관계데이터모델  (1) 2026.09.29

https://velog.io/@youngjun_10/BackEnd-기술-면접-질문-정리


BackEnd 기술 면접 질문 정리

객체지향 프로그램 구현에 필요한 객체를 파악하고 각각의 객체들의 역할이 무엇인지를 정의하여 객체들 간의 상호작용을 통해 프로그램을 만드는 것을 말한다. 절차지향 프로그래밍이란? 프

velog.io

https://dncjf64.tistory.com/479


3개월 동안 면접 25군데 본 백엔드 경력 이직 후기

안녕하세요.이번글은 퇴사 후 3개월 동안 면접을 25군데 보고 첫 경력 이직에 성공한 후기를 남기려고 합니다.전체 과정에서 이직을 어떻게 준비했어야 할지, 남은 커리어를 어떻게 일해야 할지

dncjf64.tistory.com

https://jeong-pro.tistory.com/240


자바 백엔드 4년차 N사 경력 면접 후기(부제 : 면접을 이끄는 건 누구인가?)

쓸데없는 서론 지금 다니는 회사 동료분들 중 몇 분이 내 블로그를 알고 있기 때문에 면접 봤다는 이야기가 알려지면 좋을 것이 하나도 없지만, 면접이 주는 영감? 동기부여?가 있기도 하고 공유

jeong-pro.tistory.com

https://spartacodingclub.kr/blog/2024-backend-jobinterview-question


백엔드 면접 질문 문제은행 - 개발자 면접 준비 101

백엔드 면접 질문 문제은행 20선 - 1) SQL과 NoSQL 데이터베이스의 차이점은 무엇인가요? 2) 가기 전 이건 무조건 생각하고 가세요. 만약...

spartacodingclub.kr


인프라에 대한 첫글 ㅎㅎ

배포 전략의 종류를 몇가지 알아보자


1. Recreate

모든 서버 중지 후에 새로운 버전 배포 후 다시 서비스를 올리는 방식

다운타임이 발생하는 배포전략이라 잘 사용되지는 않음


2. Rolling

여러대의 서버가 있을때 새로운 버전의 서비스를 서버마다 순차적으로 배포

한대의 서버를 셧다운하고, 로드밸런서로 나머지 하나의 서버로 트래픽을 다 밀어넣고

셧다운 된 서버에 새로운 버전을 배포 한 후 서비스를 올리는 방법.

하나 서버가 완료되면 나머지 하나의 서버도 동일한 방식으로 배포한다.


3. blue/green

blue는 구버전, green은 신버전을 의미하며

새로운 버전을 모두 배포하고, L4에서 새로운 버전의 서버로 거래가 유입되도록 하는 방법.


4. canary

특정 서버에만 선 배포를 진행하여 오류 여부를 확인하고 문제가 없다고 판단되면 모든 서버에 새로운 버전으로 

배포하는 방식이다.

문제발생시 선배포한 서버만 롤백하면 되어 롤백이 간단하다.


firebase with coroutines

문제 상황

firebase를 이용하다가 보면 라이브러리에서 제공하는 대부분의 메서드는 listener를 통해 비동기로 응답을 보내주고, 그 응답을 가공하여 사용해야 하는 경우가 많다

예를 들어

fun subscribeWalkingDistanceData(successCallback : () -> Unit, failureCallback : () -> Unit){
    Fitness.getRecordingClient(GlobalApplication.getApplicationContext(),mGoogleSignInAccount).subscribe(DataType.TYPE_DISTANCE_DELTA)
.addOnSuccessListener{
	Log.d(TAG,"successfully subscribe distance delta")
	successCallback()
}.addOnFailureListener{
		Log.e(TAG,"there was a problem subscribing walking distance data${it.localizedMessage}")
	failureCallback()
	}
}

위와 같이 유저가 이동한 거리에 대한 데이터를 subscribe를 하기 위해 다음과 같은 메서드를 작성했다면, 각각 성공 실패 리스너를 통해 firebase가 어떤 응답을 주는가에 따라서 매개변수로 받은 콜백함수를 실행시키는 형태로 코드를 작성 할 수 있다.

그런데 이렇게 코드를 작성하다 보면 콜백지옥의 문제가 생긴다.

depth가 하나일 때는 무난하게 callback함수를 매개변수로 넘겨 실행 시켜도 문제가 없지만

depth가 깊어질 수록 매개변수로 콜백을 계속 물고 들어가기 때문에 점점 복잡해지는 문제가 생긴다.

사실 이전에는 콜백으로 처리하였는데, 이번에 MVP패턴을 적용하면서 함수를 단순한 기능의 형태로 쪼개다보니 파이어베이스에서 받아온 응답 데이터를 그대로 return 해줘야 하는 함수들을 만들기 시작했고, 이에 다른 방법을 찾아보게 되었다.

해결 방법

구글링 결과 이를 해결하기 위해서 파이어베이스 메서드를 비동기처리하는 라이브러리를 추가하면 된다는 사실을 알게되었다.

https://github.com/Kotlin/kotlinx.coroutines/tree/master/integration/kotlinx-coroutines-play-services

  1. 모듈 수준 gradle에 dependency를 추가해주자

implementation **'org.jetbrains.kotlinx:kotlinx-coroutines-play-services:1.6.2'**

  • 현재기준 1.6.2가 가장 최신 버전이다.
  1. dependency를 추가한 후 firebase에서 제공하는 라이브러리 안의 함수를 호출할 때 .await()를 사용할 수 있게 되어 응답이 올 때 까지 대기 할 수 있게 된다.
  2. 코드를 바꿔보자.
/*하루동안 걸은 거리 관련 함수 */
//피트니스 데이터(걸은 거리)
suspend fun subscribeWalkingDistanceData(){
    Fitness.getRecordingClient(GlobalApplication.getApplicationContext(),mGoogleSignInAccount).subscribe(DataType.TYPE_DISTANCE_DELTA)
     .addOnSuccessListener{
		}.addOnFailureListener{
	}

val response = Fitness.getRecordingClient(GlobalApplication.getApplicationContext(),mGoogleSignInAccount)
        .subscribe(DataType.TYPE_DISTANCE_DELTA).await()
}

위처럼 리스너에 콜백 함수를 지정하는 방식에서 밑에 await를 통해 응답이 올때까지 대기 한 후 response라는 변수에 응답으로 온 데이터를 할당하는 방식으로 바꿀 수 있다.

google play api는 google play service의 하나의 파트 임.

google fit api는 안드로이드 4.1 이상부터 호환.

Google Fit API 장점

  • 거의 실시간의 히스토리 데이터를 적은 에너지의 블루투스 디바이스로부터 가져옴
  • 활동들을 기록 할 수 있음
  • 데이터를 세션과 연관시킬 수 있음
  • 피트니스 목표를 설정 할 수 있음

sensor data

  • 유저의 하루 활동 관련한 정보들을 앱에서 제공한다면 (예를 들어 하루동안의 걸음수), sensor data는 사용자의 행동을 거의 실시간으로 보여주는데 사용이 가능함.

record data

  • 앱이 꺼져있는 상황에서도 계속해서 데이터를 적재 할 수 있는 subscribe 메서드를 제공함

historical data

  • 만약 유저가 과거의 활동들로부터 피트니스 데이터를 보여주기를 원한다면 history api를 사용하면 됨
  • 데이터 subscribe가 선행 되어야 historical data를 읽을 수 있음 ( 도큐먼트가 친절하지 않아서 테스트 후에 알게 됨), 데이터가 없으면 빈 리스트로 응답이 옴.

session data

  • 개발자가 일정한 시간의 세션을 설정하고 그 설정안에 들어가는 범위의 데이터를 가져올 수 있음

내가 하고자 하는 것

  1. subscribe를 통해 앱 사용자의 활동내역(현재는 걸음 수, 이후에 추가할 예정)들을 클라우드 형태의 google fit store에 앱을 종료했을 때도 마찬가지로 계속해서 저장해야 함.
  2. 데이터가 있는 날부터 일(00시~24시) 기준으로 걸음 수 데이터를 보여줄 수 있어야 함
  3. 배터리 최적화, 잠자기 모드 등 예기치 못한 상황에서도 정상적으로 데이터를 가져와야 함
  4. 데이터는 자정 기준으로 새로 시작함

사전 준비

  1. google fit api 는 Google API Console 에 프로젝트를 등록 및 client ID 를 발급 받은 후 사용해야함.
  2. client ID 발급 후 사용할 library에서 google fit api 를 사용 설정 해야 함.
  3. 테스트를 위해서 OAuth 동의 화면 탭의 테스트 사용자에 테스트를 수행 할 사용자 정보를 등록해야 함.
  4. 모듈 범위의 gradle 에
plugin {
    id("com.android.application")
}

...

dependencies {
        implementation("com.google.android.gms:play-services-fitness:21.1.0")
        implementation("com.google.android.gms:play-services-auth:20.2.0")
}

다음 과 같이 dependency를 추가하여 필요한 라이브러리를 다운로드 함

  1. https://developers.google.com/fit/android/get-started 를 참고하면 더 자세히 setup에 관해 나와 있음

구현 방법

  1. fitness option 객체를 만들어 내가 사용하고자 하는 data들을 추가함
funcreateFitnessStepOptions() : FitnessOptions{
	val fitnessOptions = FitnessOptions.builder()
        .addDataType(DataType.TYPE_STEP_COUNT_DELTA, FitnessOptions.ACCESS_READ)
        .addDataType(DataType.AGGREGATE_STEP_COUNT_DELTA, FitnessOptions.ACCESS_READ)
        .addDataType(DataType.TYPE_DISTANCE_DELTA, FitnessOptions.ACCESS_READ)
        .addDataType(DataType.AGGREGATE_DISTANCE_DELTA, FitnessOptions.ACCESS_READ)
        .build()
	return fitnessOptions
}

걸음수와 지금까지 걸은 거리에 대한 데이터를 얻기 위해 위처럼 4개의 fitness data type을 추가함.

  1. google account를 가져옴
fun getAccount(fitnessOptions: FitnessOptions) : GoogleSignInAccount{
	val account = GoogleSignIn.getAccountForExtension(GlobalApplication.getApplicationContext(),fitnessOptions)
	return account
}

getAccountForExtension 메서드를 이용하여 추가한 데이터에 대한 인증을 사용하는 google signin account를 얻음.

  1. google fit api를 사용하기 위한 권한 요청
fun checkHasGrantedDataAccess(account: GoogleSignInAccount, fitnessOptions: FitnessOptions, callback: () -> Unit){
    Log.i(TAG,"checkHasGrantedDataAccess${account.id}, fitnessOptions${fitnessOptions}")
if(!GoogleSignIn.hasPermissions(account, fitnessOptions)){
	//해당 google id가 permission이 허용되었는지 체크함.
	Log.d(TAG,"!GoogleSignIn.hasPermissions")
	GoogleSignIn.requestPermissions(mActivity,GOOGLE_FIT_PERMISSIONS_REQUEST_CODE, account, fitnessOptions)
  }else{
	  callback()
  }
}

account 가 접근하고자 하는 google fit api data에 대한 권한이 있는지 체크하고, 권한이 있다면 callback함수를 실행함. 없다면 권한을 요청함.

  1. 걸음 수 / 걸은 거리 데이터 구독 시작
//피트니스 데이터(걸음 수)구독셋팅
fun subscribeStepCountData(successCallback: () -> Unit?, failureCallback: () -> Unit?){
    Fitness.getRecordingClient(GlobalApplication.getApplicationContext(),mGoogleSignInAccount)
  .subscribe(DataType.TYPE_STEP_COUNT_DELTA)// no scopes are specified.
	.addOnSuccessListener{
	Log.i(TAG,"successfully subscribe step count data!!")
	  successCallback()
	}.addOnFailureListener{
	Log.w(TAG,"there was a problem subscribing step count data${it}")
	  failureCallback()
	}
}

  1. 걸음 수를 원하는 날짜부터 가져옴 (수정 중)
fun getStepCountForDays(days : Int){

	val cal = Calendar.getInstance()
	val now = Date()
	    cal.time= now
	val endTime = cal.timeInMillis
	
	cal.set(Calendar.HOUR_OF_DAY, -days)
	    cal.set(Calendar.MINUTE, 0)
	    cal.set(Calendar.SECOND, 0)
	    cal.set(Calendar.MILLISECOND, 0)
	
	val startTime = cal.timeInMillis
	
	val readRequest = DataReadRequest.Builder()
	        .aggregate(DataType.TYPE_STEP_COUNT_DELTA, DataType.AGGREGATE_STEP_COUNT_DELTA)
	        .bucketByTime(1, TimeUnit.DAYS)
	        .setTimeRange(startTime, endTime, TimeUnit.SECONDS)
	        .build()
	
	    Fitness.getHistoryClient(mActivity,mGoogleSignInAccount)
	    .readData(readRequest)
	    .addOnSuccessListener{
	response->
	for(dataSetinresponse.buckets.flatMap{ it.dataSets}) {
	  Log.i(TAG,"dataSet ==${dataSet}")
		//원하는 로직 추가 }
	}.addOnFailureListener{
		//실패 처리로직 추가
	}
}

원하는 날부터 현재까지 일 단위의 걸음 수 데이터를 가져오는 로직

결과

테스트를 해보려고 구글 피트니스 앱과 데이터를 비교한 결과 데이터가 잘 조회 되는 것을 확인하였음. 이 과정에서 한번 더 고민하고 액션을 취했던 부분은 혹시나 하는 마음에 매일 자정이 되기 찰나의 순간에 하루동안의 데이터를 조회해 오는 메서드 readDailyTotal 를 호출하여 데이터를 저장하는 방법과, DataReadRequest 객체에 startTime과 endTime을 설정해 그 기간동안의 data를 가져와 사용하는 방법 간 데이터 결과에 차이가 있는가에 대한 테스트를 했고 데이터간 차이가 없는 것을 확인하고 후자의 방식으로 채택했음. 그러나 startTime과 endTime을 잘못 설정하면 자정이 기준이 아니고 현재 시간을 기준으로 하루가 책정되기 때문에 startTime과 endTime을 설정을 자신이 필요한 데이터에 따라 정확히 할 필요가 있음.

Chronometer를 이용한 스톱워치 구현

<Chronometer
android:id="@+id/timer"
android:layout_width="200dp"
android:layout_height="40dp"
android:textSize="16sp"/>

xml파일에 다음과 같이 Chronometer 를 추가함.

나는 start, pause, stop 버튼에 각각 시작, 일시정지, 중지 기능을 추가해 넣었음.

전역변수로는 일시 정지를 누른 시간을 저장함

fun startTimer(){
	timer.base= SystemClock.elapsedRealtime() +pauseTime
  timer.start()
}

fun pauseTimer() {
	pauseTime=timer.base- SystemClock.elapsedRealtime()
	timer.stop()
}

fun resetTimer(){
	pauseTime= 0L
	timer.stop()
}

각각 버튼의 클릭리스너에 기능에 맞는 함수를 호출하면 됨.

여기서 timer는 Chronometer 임**.**

1. 하고자 하는 기능?

사용자가 자신이 갔던 경로를 트랙킹하여 지도에 표시해 타 사용자들에게 공유하는 기능

2. 프로세스

  1. 해당 화면 접근 시 런타임에 위치 권한 체크
  2. 위치 권한 허용 시 (3)으로 이동, 거부시 (5)로이동
  3. start 버튼 선택 시 현재 내 위치로 이동 및 tracking시작
  4. 설정한 시간 간격으로 위치를 얻어와 지도 위에 선으로 표시
  5. stop버튼 선택 시 tracking 종료
  6. 위치 권한 재 요청, 2번 거부 시 수동으로 앱 설정에 가서 허용하라는 다이얼로그 표시

3. 구현 방법

3-1) 런타임 위치 권한 체크

** 위치 권한 체크 시 유의할 점

내가 구현하고자 했던 기능은 앱이 백그라운드 상태에 가 있을 때에도 사용자의 위치를 추적해야 했다. 안드로이드 6부터는 앱에서 필요한 권한이 있을 때 런타임에서 권한을 받게 되었는데, 위치 권한은

<uses-permission android:name="android.permission.ACCESS_COARSE_LOCATION" /> <uses-permission android:name="android.permission.ACCESS_FINE_LOCATION" />

manifest.xml

ACCESS_COARSE_LOCATION, ACCESS_FINE_LOCATION 두개의 권한을 받아 사용하였다. 첫번째 줄에 선언한 권한은 네트워크 만을 이용하여 대략적인 위치 정보를 요청하는 권한이고 두번째 줄에 선언한 권한은 GPS와 네트워크를 이용하여 정확한 위치 정보를 요청하는 권한이다. ACCESS_FINE_LOCATION 권한은 반드시 ACCESS_COARSE_LOCATION권한이 허용되어야 한다.

백그라운드에서의 위치 권한은 안드로이드 10 미만으로는 따로 선언하지 않고 사용할 수 있다.

안드로이드 10 이상 부터는 위치 정보 사용이 포그라운드/ 백그라운드로 나누어지게 되는데 백그라운드에서 위치 권한을 사용하려면

<uses-permission android:name="android.permission.ACCESS_BACKGROUND_LOCATION" />

manifest.xml

ACCESS_BACKGROUND_LOCATION 권한을 따로 요청해야한다.

안드로이드 11이상 부터는 백그라운드에서 위치정보 사용 시 런타임 권한을 두 번 요청 해야한다.

포그라운드/ 백그라운드 위치 권한을 동시에 받으면 제대로 권한 체크가 되지 않고 무시하게 된다.

백그라운드 위치 권한은 왜 백그라운드 위치 권한을 받는지에 대한 다이얼로그와 함께 백그라운드 위치 권한을 사용자가 허용으로 설정할 수 있도록 설정 페이지로 보내주어야 하며 사용자 선택에 따른 결과 처리도 알맞게 따로 해주어야 한다.

3-2) 좌표 값 얻기

나는 Google Play 서비스 Location API를 사용하여 일정한 시간 주기로 좌표 값을 가져왔다. FusedLocationProviderClient가 제공하는 getCurrentLocation 메서드를 이용하여 현재 위치 값을 가져왔다. 문서에는 getLastLocation메서드를 사용해 좌표값을 가져오는 것을 권장한다고 적혀있지만 이전 프로젝트에서 사용했을 때 위치 설정을 막아 놓았다가 막 켠 상태라면 저장되어 있는 좌표 값이 없어 좌표가 null로 반환되는 오류가 있었다. 이 때문에 지속적으로 위치 정보를 가져오지 않고 한번만 가져와도 무방하다면 getCurrentLocation 메서드를 사용하는게 더 좋다고 생각한다.

계속해서 업데이트 되는 좌표를 얻기 위해서는 requestLocationUpdates 메서드를 사용하여 지속적으로 위치를 업데이트 할 수 있다. 위치 정보를 가져올 시간 간격, 정확도를 설정해 LocationRequest객체를 생성하여 설정한 간격으로 좌표값을 가져온다.


환경 변수 란 ?

어떠한 프로세스가 실행될 때 영향을 미치는 동적인 값

OS 단에 선언되어있는 배포 환경에 따라 값을 동적으로 변경하기 위한 변수

내가 하고 싶었던 건?

환경변수인 NODE_ENV 값을 local, development, production으로 각각 나누어 의도한 바에 따라 .env파일을 분기하여 사용하고 싶었다

시행착오

  1. process.env 환경변수를 vue.파일의 script 태그 안에서 콘솔로 로그를 찍으니 계속 undefined를 얻었다.. → client side에서는 process.env를 사용 할 수 없다는 사실을 모르고 있었다. 알고보니 process.env는 server side에서만 사용이 가능했고, clientside에서도 활용이 가능하게 하기 위해 nuxt에서는 nuxt.config.ts 파일 안에 config 설정을 따로 두고 있었다.
  2. cmd 에서 환경변수를 set하는 방법을 몰라서 한참을 헤맸다. package.json 의 scripts 부분 안에 있는 명령어들을 지정할 때이런 방식으로 환경변수를 셋팅 하니 잘 동작했다.
  3. SET 환경변수명=값 & nuxt build
  4. SET NODE_ENV를 변경해도 저절로 .env 파일을 찾아가지 못했다. 예전 Vue CLI를 이용해서 프로젝트를 생성했을때는 뒤에 --mode local 이런 방식으로 지정하면 .env.local 파일의 변수값을 바라보게 자동으로 셋팅이 되었는데, Nuxt3는 그렇게 되지 않았고const phase = process.env.PHASE!!주의할 점!!따라서 nuxt.config.ts 안에서 process.env값을 runtimeConfig로 정의하여 컴포넌트 안에서 사용해야한다.
  5. nuxt에서는 process.env 값을 component안에서 console로 찍어 확인하면 nuxt.config.ts 안에서의 process.env 값과 다르다.
  6. require(’dotenv’).config({path:./.env${phase}})
  7. 해결방법으로 스크립트에 PHASE라는 환경변수값을 셋팅하고, 그값을 찾아와 nuxt.config.ts 파일 에서 dotenv의 파일 path값을 동적으로 바꿔주었다. ex) SET PHASE=local&&nuxi dev

+ Recent posts